Jev로 버그를 찾을 수 있을까
요즘 화제인 Jev를 실제 Cantina 경쟁 코드로 시험해 봤습니다. 두 모델을 엮자 확정된 버그 9건 중 5건이 상위 15개 함수에 들었습니다. 먼저 읽을 함수를 고르는 데는 쓸 만하다는 뜻입니다. 하지만 옆 함수까지 봐야 하는 버그는 모두 놓쳤습니다. 왜 의심스러운지도 말해 주지 않습니다. 그래서 버그를 찾는 일에는 아직 이르다고 봅니다. 심사하는 쪽에서 중복 리포트를 가려내는 데는 꽤 쓸모가 있어 보입니다.
9월 15일 TypeSafe AI가 Jev를 공개했습니다. 닷새 뒤 누구나 쓸 수 있게 열었는데, 사람이 너무 몰려서 9월 22일에는 신규 가입을 잠시 막아야 했습니다.
we are officially out of stealth! join the frontier and get access to Jev on our website (link on profile)
버그 바운티에 써먹을 수 있을지 궁금해서 문서와 사람들이 공개한 테스트 결과를 찾아봤습니다. 실제 오딧 경쟁 코드에도 직접 돌려 봤습니다. 결론부터 말하면 어떤 함수부터 읽을지 고르는 데는 쓸 만했습니다. 하지만 버그를 찾는 데는 아직 이릅니다. 함수 여러 개에 걸친 버그를 놓쳤기 때문입니다. 오히려 심사하는 쪽에서 중복 리포트를 가려낼 때 더 쓸모가 있어 보입니다.
Jev는 글을 쓰지 않는다
Jev에게는 상황(state)과 질문을 줍니다. 상황은 문자열이든 JSON이든 상관없습니다. 질문은 미리 정해 둔 형식으로 묻습니다. 그러면 Jev는 문장 대신 확률을 돌려줍니다. 질문 형식은 세 가지입니다.
| 질문 | 예를 들면 | 받는 답 |
|---|---|---|
| Choice | 이 중 어느 쪽인가 | 선택지별 확률 |
| Score | 정해 둔 척도로 몇 점인가 | 점수와 단계별 확률 |
| Noul | 이 말이 맞는가 | 0에서 1 사이 확률 |
한 상황에 질문을 여러 개 붙여도 한 번에 병렬로 답합니다. 응답은 70~500밀리초 만에 옵니다. 가격은 입력 토큰 100만 개에 $0.042이고 출력은 공짜입니다. 답의 형식이 정해져 있으니 그 바깥의 엉뚱한 답이 나올 일도 없습니다.
TypeSafe는 합성 데이터로만 학습한 트랜스포머 모델이라고 설명합니다. 학습 방식에는 Reinforcement Learning for Calibrated Decisions라는 이름을 붙였습니다. 논문이나 가중치는 공개하지 않았습니다. CEO인 Diogo Almeida는 OpenAI에서 InstructGPT와 ChatGPT 작업에 참여했던 사람입니다.
이름은 경제학자 윌리엄 스탠리 제번스(William Stanley Jevons)에서 따왔습니다. 제번스는 자원이 싸지면 오히려 더 많이 쓰게 된다고 봤습니다. TypeSafe는 Jev를 "System One" 모델이라고 부릅니다. LLM처럼 천천히 추론하는 대신 빠르고 직관적으로 판단한다는 의미입니다. a16z 인터뷰에서도 Jev를 소프트웨어 안에 들어가 사는 모델로 소개합니다.
TypeSafe AI's Diogo Almeida with a16z's Ben Horowitz and Martin Casado on Jev, the model built to live inside software:
Diogo's elevator pitch for Jev is a simple question - where is all the automation?
AI is unbelievably smart, but outside of chatbots and coding agents, it…
실제 오딧 경쟁으로 실험해 보니
제가 찾은 공개 테스트는 보안 알림이나 보고서를 다룬 것들이었습니다. 코드에 돌려 본 결과는 없어서 직접 실험해 봤습니다. 대상은 2026년 1월 12~26일 Cantina에서 열린 VII Finance 경쟁입니다. 범위 안의 코드(core-contracts, yield-harvesting-hook)를 함수 146개로 나눴습니다. 그리고 판단 모델 두 개에 함수마다 버그가 있을 확률을 물었습니다. Jev 1.13과 OpenAI의 GPT-6 Luna decisions입니다. 이 확률로 함수 순위를 매긴 뒤, Cantina 오딧 리포트에서 확정된 High와 Medium 9건이 몇 위에 있는지 확인했습니다. 무작위로 고르면 상위 15개에 평균 1.2건 정도가 들어옵니다.
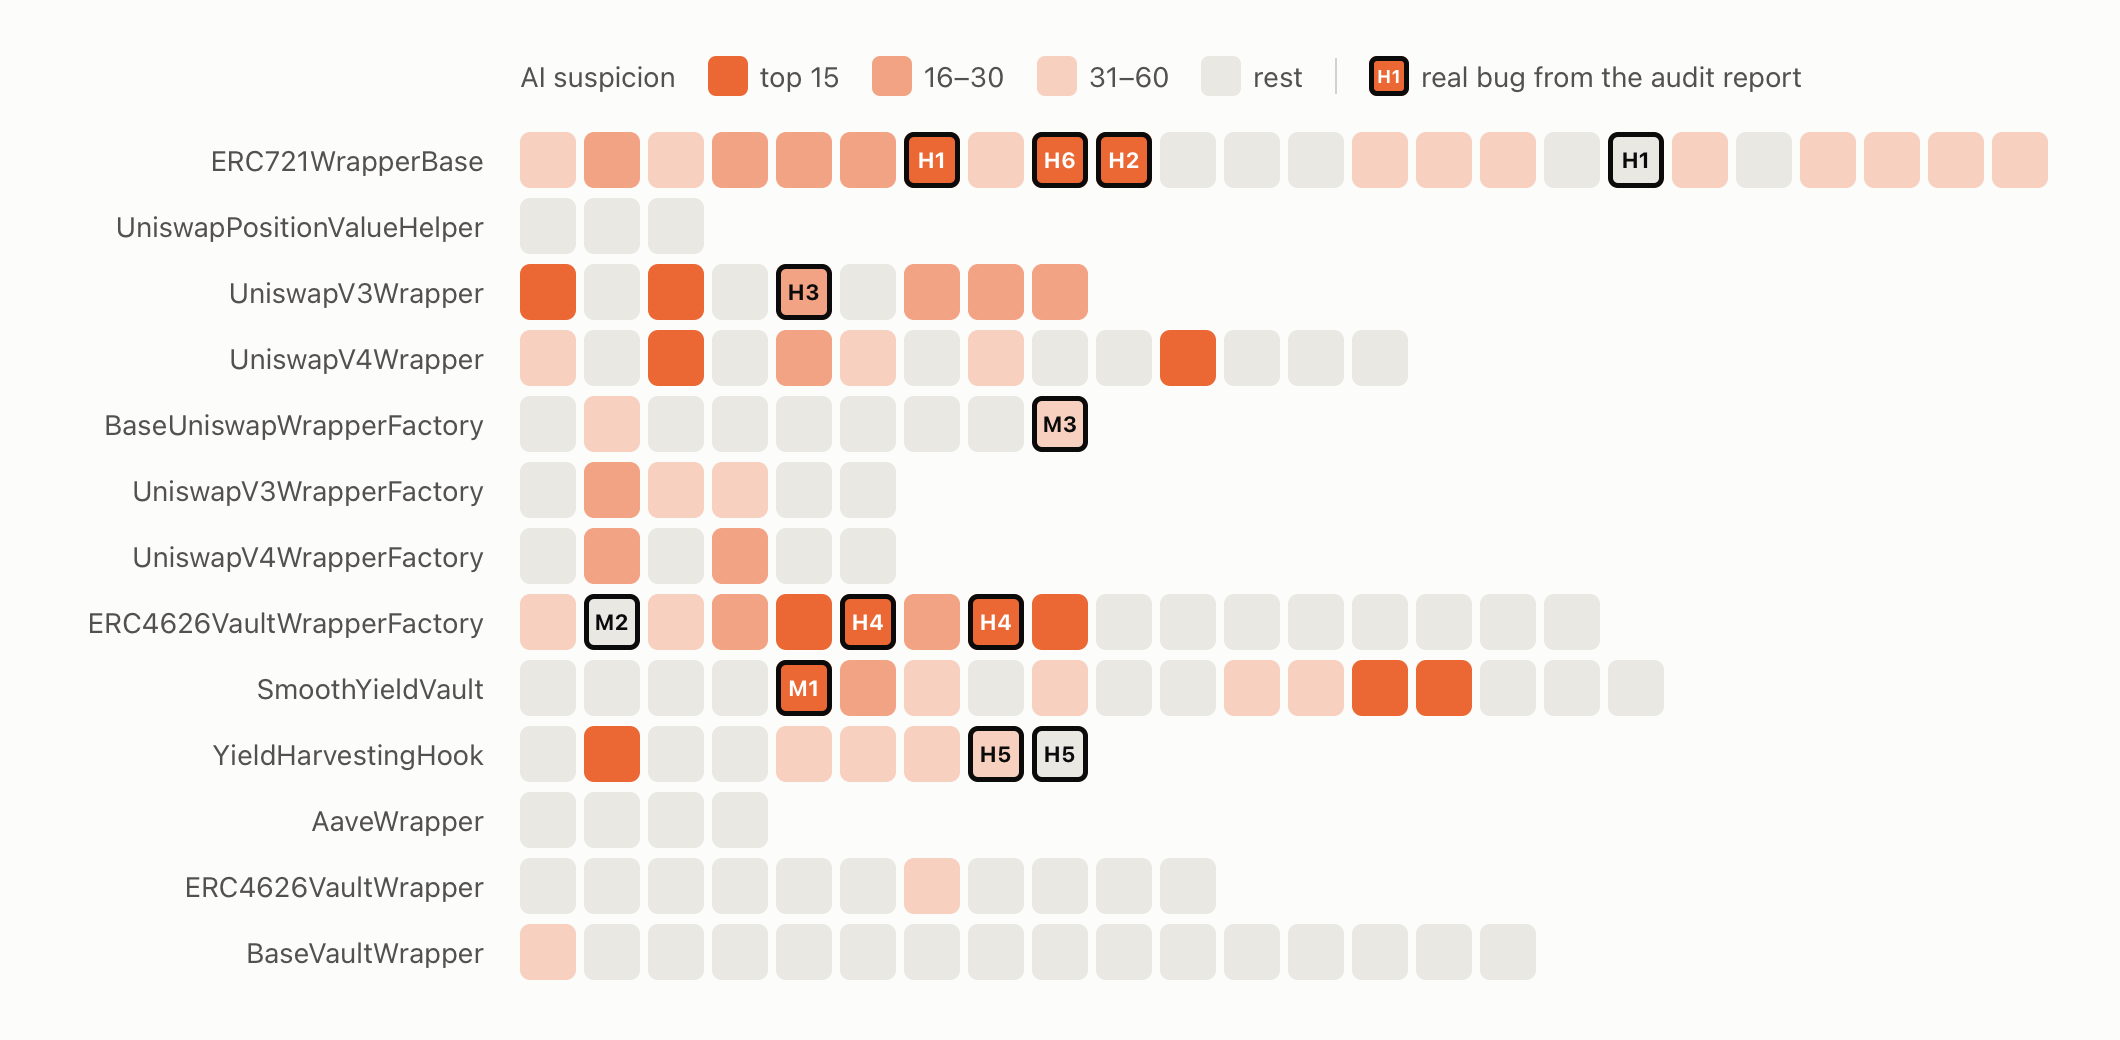
"이 함수에 실제로 악용할 수 있는 버그가 있는가"라는 질문 하나만 던졌을 때 Jev는 상위 15개에 9건 중 3건을 넣었습니다. Luna는 최대 4건이었습니다. 코드를 얼마나 보여 주느냐보다 어떻게 묻느냐가 더 중요했습니다. 재진입, 접근 제어, 오라클 조작, 수학, 서명, 프록시까지 체크리스트 질문 여섯 개의 평균을 내자 Jev의 평균 정밀도(average precision)가 0.17에서 0.35로 두 배가 됐습니다. 질문마다 잡아내는 버그가 달랐기 때문입니다. 오라클 질문은 H2와 H6을 위로 끌어올렸습니다. 접근 제어 질문은 H1과 H4를 잡았습니다. 맥락을 더 주는 효과는 그보다 작았습니다. 호출자와 피호출자 정보를 주자 Luna의 상위 15개에 든 버그가 2건에서 4건으로 늘었습니다. 프로젝트 주석을 넣으면 두 모델 모두 오히려 조금 나빠졌습니다.
가장 좋은 결과는 두 모델을 두 단계로 엮었을 때 나왔습니다. Jev가 체크리스트로 상위 30개를 추리면, Luna가 각 함수의 호출자와 피호출자까지 보면서 그 30개의 순위를 다시 매깁니다. 이렇게 하니 9건 중 5건이 상위 15개에 들었습니다. 무작위로 고를 때의 약 4배입니다. 코드 전체를 한 번 훑는 데는 1센트 정도 듭니다. 두 모델이 서로의 약점을 메운 덕분입니다. Luna는 무엇을 묻든 ERC4626VaultWrapper의 변환 함수를 100% 가까이로 평가했습니다. 겉보기에는 뒤바뀐 것 같습니다. 하지만 원래 의도된 설계입니다. Jev의 체크리스트는 이 함수들을 상위 30개에 넣지 않았습니다. 그래서 Luna에게 넘어갈 일이 없었습니다. 후보를 20개로 줄여도 결과는 5건으로 같았습니다. 40개로 늘리면 3건으로 떨어졌습니다.
놓친 버그에는 분명한 공통점이 있습니다. 함수 하나 안에서 보이는 버그 두 건(H2, M1)은 모두 상위 15개에 들었습니다. 옆 함수까지 봐야 하는 버그 두 건은 하나도 들지 못했습니다. 풀 통화가 네이티브 ETH일 때 생기는 서비스 거부(H5)는 29가지 설정 어디에서도 상위 15개에 오르지 못했습니다. 팩토리 함수 두 개가 같은 salt를 쓰는 문제(M2)는 딱 한 번 올랐습니다. 소수점 자릿수가 18이 아닌 단위의 가격을 잘못 매기는 오라클(M3)도 한 번뿐이었습니다. 세 버그 모두 채점 중인 함수 바깥의 정보가 있어야 보입니다.
물론 경쟁 하나, 버그 9건으로 한 실험이라 첫인상 정도로 봐 주시면 좋겠습니다. 체크리스트 평균과 두 단계 구성처럼 성적이 좋았던 설정 몇 개는 결과를 보고 나서 고른 것입니다. 새 코드에서는 숫자가 더 낮게 나올 수 있습니다. 리포트에는 Low 5건의 내용이 없습니다. 그래서 "오탐" 중 일부는 실제 Low 이슈일 수도 있습니다. 29가지 설정을 모두 돌리는 데 든 API 비용은 약 $0.37입니다.
버그를 찾는 데는 아직 이른 이유
Jev가 가장 잘하는 건 빠른 판단인데, 버그 바운티에는 그 속도가 별로 필요 없습니다. 배포된 컨트랙트의 버그는 대개 누가 제보하기 전까지 그 자리에 있습니다. 유효한 버그 하나를 잡으려고 며칠씩 코드를 읽고 테스트를 돌리는 일도 흔합니다. 보상이 나오느냐는 근본 원인을 제대로 짚었느냐에 달려 있습니다. 한 번 훑는 데 1센트면 1차 필터로 돌리기에는 충분히 쌉니다. 그 뒤의 며칠은 코드를 끝까지 따라가 보고 왜 문제인지 설명해 주는 모델과 보내는 편이 낫습니다.
실험 결과와 공개된 테스트를 겹쳐 보면 한계가 더 분명해집니다.
- Jev는 확률만 줍니다. 함수 옆에 0.83이라고 떠도 어느 줄이 문제인지, 누가 호출하는지, 어떤 불변식이 깨지는지는 알 수 없습니다. 리포트를 쓰려면 이 셋이 다 필요합니다. 여기에 동작하는 PoC까지 있어야 합니다. 순위가 높다고 모델이 버그를 이해했다는 뜻도 아닙니다.
- 놓친 버그가 하필 Jev가 약한 곳에 있습니다. TypeSafe의 1.13 버전 문서는 산술, 날짜 비교, 간접 참조, 수치 추론을 믿고 맡기기 어렵다고 스스로 밝힙니다. 반올림 오류, 오래된 타임스탬프, 프록시나
delegatecall을 거치는 접근 제어가 딱 그런 종류입니다. 호출을 따라 옆 함수로 넘어가야 보이는 버그도 마찬가지입니다. - 프롬프트를 많이 탑니다. 제 실험에서도 질문 문구가 결과를 가장 크게 바꿨습니다. Torq의 알림 분류 테스트에서는 지시문 한 줄을 바꾸자 거의 모든 알림을 악성으로 보던 Jev가 거의 아무것도 악성으로 보지 않게 됐습니다. 프롬프트를 대충 쓰면 모든 알림을 한 클래스로 몰아넣기도 했습니다. 임계값 0.8에서 정확도는 21.13%로, Gemini Flash(46.48%)의 절반에 못 미쳤습니다.
- 입력만으로 판단을 뒤집을 수 있습니다. Check Point는 공격자에게 실사 보고서의 한 섹션만 쓰게 했습니다. 그런데도 27번 중 25번은 누가 봐도 폰지 사기인 회사를 저위험으로 판정하게 만들었습니다. 한 번 성공하는 데 드는 비용은 50센트 정도였습니다. 코드 리뷰라면 프로젝트의 주석과 NatSpec이 그 입력입니다. 제 실험에서는 누가 일부러 조작하지 않았는데도 주석을 넣자 점수가 나빠졌습니다.
// only callable by the owner라는 주석은 개발자의 주장일 뿐입니다. 그런데 코드를 직접 따라가 보지 못하는 모델은 이걸 그대로 믿기 쉽습니다.
대신 심사할 때는 쓸모가 있어 보인다
입장을 바꿔 심사하는 쪽에서 보면 Jev에 잘 맞는 일이 있습니다. 들어온 리포트가 중복인지 확인하는 일입니다.
경쟁이나 제보가 많은 바운티 프로그램에는 같은 원인의 버그를 저마다 다른 말로 설명한 리포트가 쏟아집니다. 누군가는 새 리포트를 하나하나 읽어 보고 이미 들어온 리포트와 견주어 같은 것끼리 묶어야 합니다. 여기서 묻는 건 "이 두 리포트가 같은 버그를 말하는가"입니다. 예, 아니요로 답할 수 있습니다. 계산도 코드 추적도 필요 없습니다. 입력은 텍스트 두 개뿐입니다. Jev가 상정한 문제와 모양이 같습니다.
방법도 간단합니다. 리포트 두 개마다 Noul 질문("A와 B는 근본 원인이 같다")을 던지면 됩니다. 새 리포트마다 Choice 질문(기존 이슈 중 어느 것의 중복인가, 아니면 새 이슈인가)을 던지는 방식도 있습니다. 어느 쪽이든 1초도 안 돼 답이 옵니다. 전부 맞대 봐도 부담이 없습니다. 2,000토큰짜리 리포트 둘을 비교하는 데 $0.00017 정도입니다. 10만 쌍을 돌려도 17달러 안팎입니다. 이 일에서는 속도도 의미가 있습니다. 심사 기간에도 리포트는 계속 들어옵니다. 분류가 안 된 리포트가 하나라도 있으면 그와 엮인 판단이 줄줄이 밀립니다.
그렇다고 Jev가 낸 점수로 바로 중복 판정을 내릴 생각은 없습니다. 어떤 리포트 쌍부터 사람이 확인할지 순서를 정하는 데까지만 쓰는 게 맞다고 봅니다. 리포트는 결국 제출자가 쓰는 글입니다. 앞에서 본 Check Point 실험처럼 입력을 잘 꾸미면 Jev의 판단은 쉽게 흔들립니다. 마음만 먹으면 중복으로 묶이지 않게 쓰거나, 반대로 남의 이슈에 묻어가도록 쓸 수도 있습니다. 그런 의도가 없더라도 같은 버그를 다룬 리포트가 쓴 사람에 따라 전혀 다른 이야기처럼 읽히는 경우가 많습니다. 그래서 최종 판단과 리포트를 닫는 일은 심사자가 직접 해야 합니다.
참고: TypeSafe AI의 X 게시물, Simon Willison, TechCrunch, Wikipedia, Torq, Check Point, Penligent.